Ningún sistema de extracción automática acierta al 100% en todos los casos. Por eso, la validación de datos extraídos de documentos mediante revisión humana sigue siendo una pieza clave en cualquier proyecto de captura automatizada, incluso cuando la mayor parte del proceso ya está automatizado.
Por qué la automatización no elimina la necesidad de validación
La extracción automática de datos, por sofisticada que sea, trabaja con niveles de confianza, no con certezas absolutas. Documentos de baja calidad, formatos atípicos o escritura poco legible pueden generar extracciones incorrectas que solo una revisión humana detecta con fiabilidad.
Cómo se organiza la validación humana
1. Umbrales de confianza
Cada dato extraído automáticamente se acompaña de un porcentaje de confianza. Los campos por encima de un umbral definido se aceptan directamente; los que quedan por debajo se derivan a revisión manual.
2. Revisión dirigida a campos críticos
No todos los campos de un documento tienen la misma importancia. Priorizar la revisión manual en los campos más críticos para el negocio —importes, fechas clave, identificadores— optimiza el tiempo del equipo de validación.
Revisión completa frente a revisión por excepción
En documentación de alto riesgo se puede optar por revisar el 100% de los registros, mientras que en documentación de menor criticidad basta con revisar únicamente los casos marcados con baja confianza por el sistema.
3. Interfaz de validación eficiente
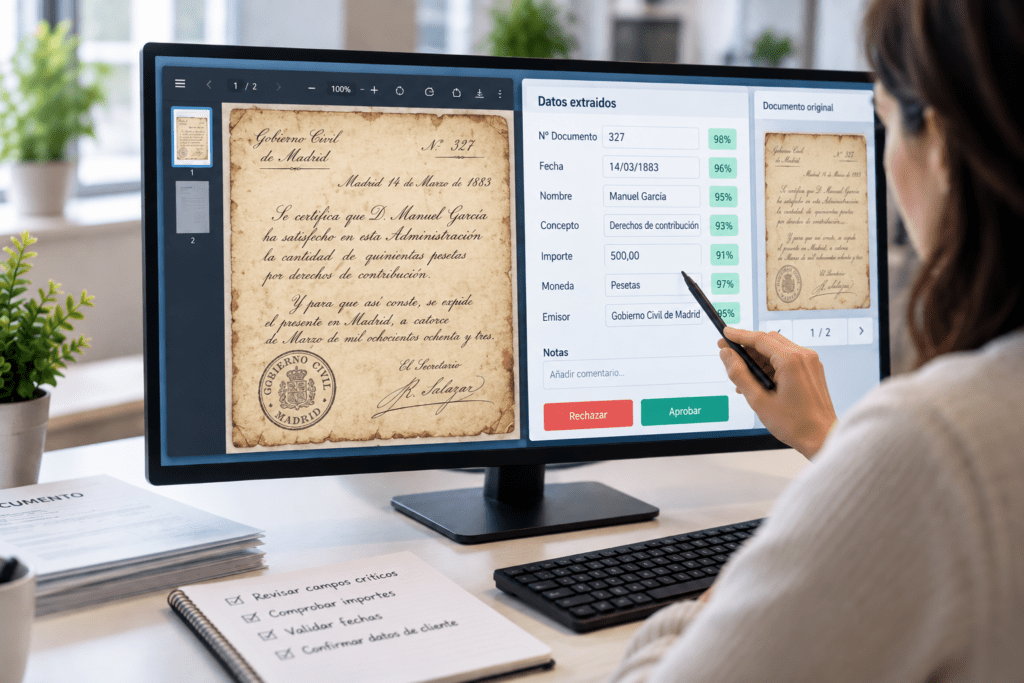
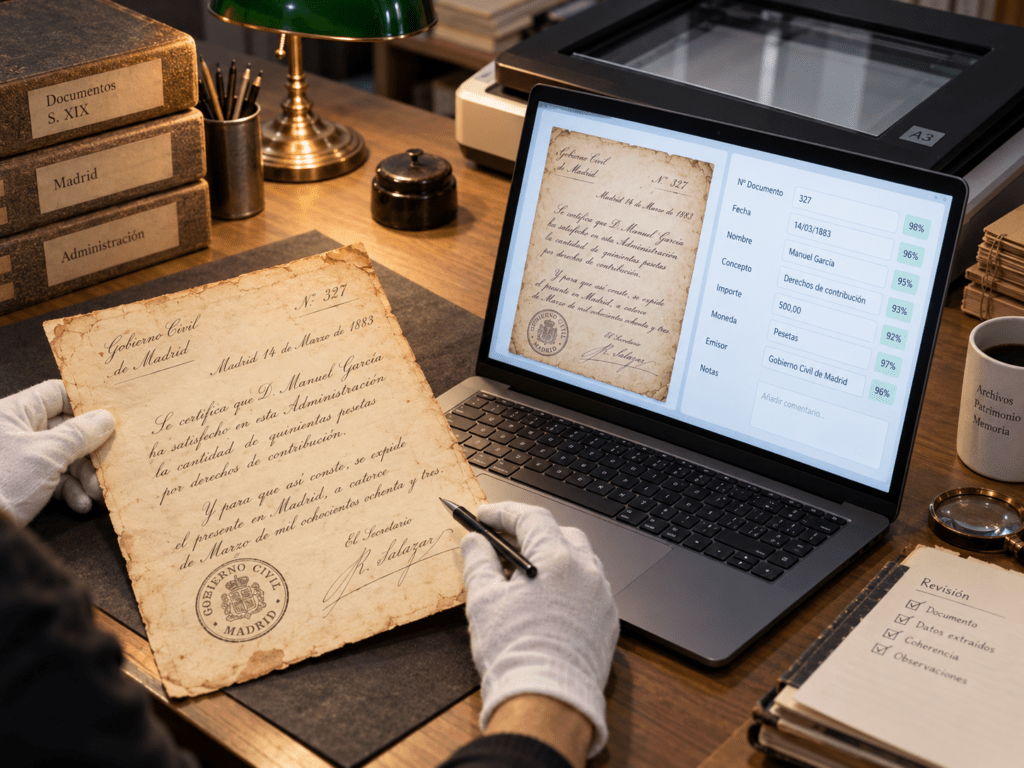
Mostrar al validador el documento original junto al dato extraído, resaltando la ubicación exacta en la página, agiliza notablemente el proceso de comprobación frente a tener que buscar manualmente cada campo.
4. Retroalimentación al sistema
Cada corrección manual debería alimentar de vuelta al modelo de extracción, mejorando progresivamente su precisión en documentos similares y reduciendo el volumen de revisión necesario con el tiempo.
Mejora continua del nivel de automatización
A medida que el sistema aprende de las correcciones, el porcentaje de documentos que requieren revisión manual tiende a reducirse, aumentando la eficiencia global del proceso con el paso del tiempo.
Equilibrio entre automatización y control
Ningún sistema de extracción automática acierta al 100% en todos los casos. Por eso, la validación de datos extraídos de documentos mediante revisión humana sigue siendo una pieza clave en cualquier proyecto de captura automatizada, incluso cuando la mayor parte del proceso ya está automatizado.
Las tecnologías actuales permiten identificar, clasificar y extraer grandes volúmenes de información de facturas, contratos, expedientes, formularios, albaranes o documentación administrativa en pocos segundos. Sin embargo, automatizar la extracción no significa eliminar por completo la posibilidad de error.
La calidad del documento, la estructura de la información, la presencia de campos manuscritos o incluso pequeñas variaciones en el formato pueden afectar al resultado. Por esta razón, los sistemas más fiables combinan automatización, niveles de confianza y revisión humana únicamente cuando resulta necesaria.
¿Por qué es necesaria la validación humana en la extracción automática de datos?
La extracción automática de datos, por sofisticada que sea, trabaja con niveles de confianza y probabilidades, no con certezas absolutas. Documentos de baja calidad, formatos atípicos, fotografías desenfocadas o escritura poco legible pueden generar extracciones incorrectas que una revisión humana puede detectar con mayor fiabilidad.
También pueden producirse errores cuando aparecen documentos diferentes a aquellos con los que inicialmente se configuró o entrenó el sistema. Una nueva plantilla de factura, un cambio en la posición de determinados campos o una nomenclatura diferente pueden reducir temporalmente la precisión.
Por eso, la validación humana funciona como una capa adicional de control de calidad que permite mantener un alto nivel de fiabilidad sin renunciar a las ventajas de la automatización.
¿Qué errores puede detectar la revisión humana de documentos digitalizados?
La revisión humana resulta especialmente útil para identificar errores difíciles de resolver automáticamente, como cifras parcialmente ilegibles, caracteres similares, campos desplazados o información escrita a mano.
Por ejemplo, determinados sistemas pueden confundir un «0» con una «O», un «1» con una «I» o interpretar de manera incorrecta un decimal en un importe. En documentos administrativos o financieros, pequeños errores de este tipo pueden producir consecuencias importantes.
¿Qué datos extraídos requieren mayor control antes de ser procesados?
La criticidad depende de cada proceso, pero normalmente requieren una mayor supervisión aquellos campos que desencadenan acciones posteriores dentro de otros sistemas.
Importes, números de cuenta, fechas de vencimiento, identificadores fiscales, números de contrato, referencias de expediente o datos relacionados con obligaciones legales suelen considerarse campos especialmente sensibles.
¿Qué ocurre si un dato crítico extraído automáticamente es incorrecto?
Un error aparentemente pequeño puede propagarse hacia otros sistemas si el dato se introduce automáticamente en un ERP, CRM, gestor documental o aplicación financiera.
Por este motivo, los campos críticos pueden configurarse con niveles de confianza más exigentes que otros datos secundarios. Así, el sistema permite automatizar la mayor parte del documento mientras mantiene un control adicional sobre la información que puede generar un mayor impacto.
¿Cómo se organiza un proceso de validación humana de datos extraídos?
La validación humana eficiente no consiste en revisar manualmente todos los documentos que procesa el sistema. El objetivo es diseñar un flujo en el que las personas intervengan únicamente cuando exista una razón objetiva para hacerlo.
Para conseguirlo se combinan diferentes mecanismos: umbrales de confianza, reglas de negocio, clasificación de campos según su criticidad y sistemas de validación por excepción.
¿Cómo funcionan los umbrales de confianza en la extracción de datos?
Cada dato extraído automáticamente puede acompañarse de un porcentaje o indicador de confianza. Este valor refleja el nivel de seguridad que tiene el sistema respecto al resultado obtenido.
Los campos situados por encima de un umbral previamente definido pueden aceptarse directamente, mientras que aquellos que quedan por debajo se envían a revisión manual.
El umbral no tiene por qué ser idéntico para todos los datos. Un campo informativo podría aceptar un nivel de confianza relativamente menor, mientras que un importe o identificador fiscal podría requerir un porcentaje significativamente superior.
¿Cómo definir el nivel de confianza adecuado para cada documento?
El nivel adecuado depende principalmente del impacto que tendría un error y de la precisión histórica obtenida con cada tipo de documento.
En procesos de bajo riesgo puede priorizarse la automatización, mientras que en documentación financiera, contractual o regulatoria suele ser recomendable aplicar criterios más restrictivos.
¿Se puede utilizar un nivel de confianza diferente para cada campo?
Sí. De hecho, utilizar niveles diferentes es una de las formas más eficientes de diseñar un sistema de validación.
Por ejemplo, el nombre de una empresa puede tolerar pequeñas variaciones sin afectar al proceso, mientras que un importe de una factura debería verificarse con criterios mucho más estrictos.
Esta combinación permite aumentar la automatización sin reducir el nivel de control sobre los datos realmente importantes.
¿Qué campos de un documento deben revisarse manualmente?
No todos los campos de un documento tienen la misma importancia. Priorizar la revisión manual en los campos más críticos para el negocio —como importes, fechas clave, identificadores o referencias contractuales— optimiza el tiempo del equipo de validación.
Una estrategia eficiente consiste en clasificar previamente los datos según su impacto operativo.
Los campos críticos reciben controles más estrictos, mientras que la información complementaria puede procesarse automáticamente cuando alcanza un nivel de confianza suficiente.
¿Es mejor realizar una revisión completa o una revisión por excepción?
En documentación de alto riesgo se puede optar por revisar el 100% de determinados registros o campos. Sin embargo, en documentación de menor criticidad suele ser suficiente revisar únicamente aquellos casos que el sistema identifica como dudosos.
Este segundo modelo se conoce habitualmente como validación por excepción y permite mantener la velocidad de procesamiento sin dedicar recursos humanos a comprobar información que el sistema ya reconoce con una elevada precisión.
¿Cuándo conviene revisar manualmente el 100% de los documentos?
La revisión completa puede tener sentido durante las primeras fases de implantación de un proyecto, cuando todavía no existe suficiente información histórica para conocer el comportamiento del modelo.
También puede aplicarse en determinadas operaciones económicas, procedimientos regulatorios, documentación contractual sensible o situaciones en las que un error pueda tener consecuencias legales relevantes.
Una vez demostrada la precisión del sistema, el porcentaje de documentos revisados puede reducirse progresivamente.
¿Cómo debe ser una interfaz eficiente para validar datos extraídos?
¿Tienes un gran volumen de documentos por digitalizar?
Planificamos tu proyecto de principio a fin para digitalizar tu archivo con seguridad, trazabilidad y control.
La interfaz utilizada por los validadores tiene un impacto directo sobre la productividad del proceso.
Mostrar al usuario únicamente una lista de campos obliga a consultar constantemente el documento original, ralentizando la comprobación. Una interfaz optimizada debería permitir comparar de forma inmediata el dato extraído con la información presente en el documento.
¿Cómo acelerar la revisión manual de documentos digitalizados?
Una de las soluciones más eficaces consiste en mostrar simultáneamente el documento original y los campos extraídos.
Además, el sistema puede señalar visualmente la zona exacta del documento donde se ha identificado cada dato. Así, el usuario no necesita recorrer manualmente todas las páginas para encontrar la información correspondiente.
¿Por qué es importante mostrar la ubicación exacta del dato extraído?
Cuando se procesan documentos de varias páginas, localizar cada campo manualmente puede consumir más tiempo que corregir el propio dato.
Resaltar automáticamente su posición reduce significativamente el tiempo medio de validación y permite que una misma persona revise un volumen mayor de documentos.
¿Cómo influye la interfaz de validación en el coste del proyecto?
Cuanto menor sea el tiempo necesario para confirmar o corregir cada campo, menor será el coste asociado a la intervención humana.
Por eso, optimizar la experiencia del validador es tan importante como mejorar la precisión del motor de extracción. Un sistema ligeramente menos preciso puede resultar más eficiente globalmente si la resolución de las excepciones es extremadamente rápida.
¿Cómo utilizar las correcciones humanas para mejorar la extracción automática?
Cada corrección manual puede convertirse en información útil para mejorar el sistema de extracción.
En lugar de considerar la validación únicamente como una última comprobación, puede utilizarse como parte de un proceso de aprendizaje continuo.
Las correcciones realizadas por los usuarios permiten identificar qué tipos de documentos, campos o estructuras generan más errores y ajustar progresivamente las reglas o modelos utilizados.
¿Puede un sistema de extracción aprender de las correcciones manuales?
Dependiendo de la tecnología empleada, las correcciones pueden utilizarse para reentrenar modelos, ajustar configuraciones, modificar reglas de reconocimiento o detectar nuevas variantes documentales.
El objetivo es que los errores recurrentes disminuyan con el tiempo.
¿Cómo reducir progresivamente la cantidad de documentos que necesitan revisión?
La combinación de métricas históricas y correcciones humanas permite identificar patrones.
Si determinados documentos presentan sistemáticamente niveles elevados de precisión, sus requisitos de revisión pueden relajarse. Por el contrario, aquellos que generan errores frecuentes pueden mantener controles adicionales.
¿Cómo aumenta el porcentaje de procesamiento automático con el tiempo?
A medida que el sistema incorpora información sobre documentos reales, nuevas estructuras y errores habituales, puede aumentar el porcentaje de registros procesados sin intervención humana.
De esta forma, la automatización no tiene por qué permanecer estática después de la implantación inicial. Puede evolucionar progresivamente a medida que aumenta la cantidad y calidad de los datos disponibles.
¿Cómo encontrar el equilibrio entre automatización y control de calidad?
El objetivo de la validación humana no es revisarlo todo, sino concentrar el esfuerzo humano donde realmente aporta valor: los casos dudosos, los documentos atípicos y los campos críticos para el negocio.
Un proyecto eficiente debe buscar el equilibrio entre tres variables principales: velocidad, coste y precisión.
Incrementar excesivamente los controles puede reducir el beneficio de automatizar. Sin embargo, eliminar completamente la revisión puede introducir riesgos innecesarios en determinados procesos.
¿Cómo automatizar documentos sin perder precisión en los datos?
La solución consiste en aplicar diferentes niveles de control según las características de cada documento y cada campo.
Los casos de alta confianza pueden continuar automáticamente hacia el siguiente sistema, mientras que únicamente las excepciones se muestran a un operador.
¿Qué porcentaje de documentos debería pasar a revisión humana?
No existe un porcentaje universalmente válido.
Dependerá de la calidad documental, la complejidad de la información, el nivel de entrenamiento del sistema y las consecuencias que pueda tener un error.
¿Cómo saber si se está revisando manualmente demasiada documentación?
Una señal clara aparece cuando los validadores confirman sistemáticamente información correcta sin realizar prácticamente ninguna modificación.
En ese escenario conviene analizar los umbrales de confianza y comprobar si pueden ajustarse para aumentar la automatización sin comprometer la precisión.
¿Cuándo es recomendable reforzar la validación manual de documentos?
Aunque el objetivo habitual sea minimizar la intervención humana, existen escenarios donde resulta conveniente aumentar temporal o permanentemente los controles.
Entre las situaciones más habituales se encuentran:
- Documentación con implicaciones legales o económicas relevantes.
- Proyectos en fase inicial, donde el modelo aún no está suficientemente entrenado.
- Documentos manuscritos o con una calidad de imagen deficiente.
- Nuevos formatos documentales que todavía no han sido procesados anteriormente.
- Procesos donde un error tiene un coste elevado, como pagos, contratos o cumplimiento normativo.
- Información que debe integrarse automáticamente en sistemas corporativos sin comprobaciones posteriores.
¿Por qué los documentos de baja calidad necesitan más validación?
Imágenes borrosas, documentos fotografiados desde un ángulo incorrecto, páginas con sombras, texto parcialmente oculto o escaneos con poca resolución pueden reducir la fiabilidad de cualquier sistema de reconocimiento.
En estos casos, aplicar controles adicionales permite evitar que un problema de calidad documental termine convirtiéndose en un problema de calidad de datos.
¿Qué documentos son más difíciles de procesar automáticamente?
Los documentos manuscritos, formularios con estructuras variables, documentos históricos y archivos procedentes de fotografías suelen presentar mayores desafíos que documentos digitales con una estructura estable.
¿Puede automatizarse también la detección de documentos problemáticos?
Sí. El propio sistema puede analizar características del archivo antes de iniciar la extracción e identificar problemas relacionados con resolución, orientación, páginas incompletas o baja legibilidad.
De esta forma, ciertos documentos pueden derivarse automáticamente a un circuito específico antes de que sus datos entren en sistemas corporativos.
¿Cómo combinar velocidad y fiabilidad en la automatización documental?
La validación humana bien diseñada no ralentiza la automatización: la hace más fiable.
Cuando el proceso utiliza correctamente umbrales de confianza, reglas de negocio y validación por excepción, la mayoría de los documentos puede procesarse automáticamente mientras la intervención humana se concentra únicamente en aquellos casos donde aporta un valor real.
Este enfoque permite reducir tiempos administrativos, mejorar la calidad de los datos y evitar que errores de extracción lleguen a aplicaciones empresariales posteriores.
Dinser integra procesos de validación con umbrales de confianza ajustados a la criticidad de cada tipo de documento, equilibrando velocidad y precisión en cada proyecto.
El resultado es un modelo de automatización documental en el que tecnología y supervisión humana no compiten entre sí, sino que trabajan conjuntamente: la automatización procesa el volumen y las personas resuelven las excepciones.
¿Cuáles son las preguntas frecuentes sobre validación de datos extraídos de documentos?
¿Qué es la validación de datos extraídos de documentos?
La validación de datos extraídos de documentos es el proceso de comprobar que la información obtenida automáticamente de facturas, contratos, formularios, expedientes u otros archivos coincide con la información contenida en el documento original. Puede realizarse mediante reglas automáticas, niveles de confianza y revisión humana para los casos dudosos.
¿Es necesaria la revisión humana si se utiliza inteligencia artificial para extraer datos?
Sí, especialmente cuando se procesan documentos complejos o información crítica. Los sistemas de inteligencia artificial pueden alcanzar niveles muy elevados de precisión, pero factores como una mala calidad de imagen, formatos desconocidos o texto manuscrito pueden producir errores. La revisión humana permite controlar estas excepciones sin tener que comprobar manualmente todos los documentos.
¿Cómo se decide qué datos deben revisarse manualmente?
Normalmente se utilizan niveles de confianza y reglas de negocio. Cuando un dato supera el nivel mínimo establecido, puede aprobarse automáticamente. Si la confianza es inferior al umbral o el campo se considera crítico —por ejemplo, un importe, una fecha de vencimiento o un identificador fiscal—, se envía a revisión humana.
¿La validación humana reduce la velocidad de la automatización documental?
No necesariamente. En un sistema correctamente diseñado, las personas solo revisan las excepciones y los datos que presentan dudas. La mayor parte de los documentos continúa procesándose automáticamente, por lo que se mantiene una elevada velocidad mientras se incrementa la fiabilidad del resultado final.
¿Cómo se puede reducir la revisión manual de documentos con el tiempo?
La revisión puede reducirse analizando los errores detectados, utilizando las correcciones humanas para mejorar los modelos y ajustando progresivamente los umbrales de confianza. A medida que el sistema mejora su precisión para cada tipología documental, aumenta el porcentaje de documentos que pueden procesarse automáticamente sin intervención humana.
Cuándo reforzar la validación manual
- Documentación con implicaciones legales o económicas relevantes.
- Proyectos en fase inicial, donde el modelo aún no está suficientemente entrenado.
- Documentos manuscritos o de calidad de imagen deficiente.
- Procesos donde un error tiene un coste elevado (pagos, contratos, cumplimiento normativo).
Combinar velocidad y fiabilidad
La validación humana bien diseñada no ralentiza la automatización: la hace fiable. Dinser integra procesos de validación con umbrales de confianza ajustados a la criticidad de cada tipo de documento, equilibrando velocidad y precisión en cada proyecto.