Extraer información de documentos ha dejado de depender únicamente de plantillas fijas, coordenadas predefinidas o reglas rígidas de lectura. La inteligencia artificial para extracción de datos de documentos permite identificar, clasificar, interpretar y capturar información relevante de facturas, expedientes, formularios, contratos o documentación técnica, incluso cuando el formato, la estructura o la distribución de la información cambia de un documento a otro.
Esta evolución permite automatizar procesos documentales que tradicionalmente requerían una elevada intervención manual. Gracias a tecnologías como el reconocimiento óptico de caracteres, el aprendizaje automático y los modelos capaces de interpretar el contexto de la información, es posible transformar documentos no estructurados o semiestructurados en datos preparados para integrarse en sistemas de gestión, aplicaciones empresariales o procesos administrativos.
¿Qué ventajas aporta la inteligencia artificial para extraer datos de documentos?
Los sistemas tradicionales de captura funcionan correctamente cuando los documentos mantienen una estructura prácticamente idéntica. Sin embargo, pueden perder eficacia cuando cambia el proveedor, aparece una nueva plantilla de factura, se modifica la posición de un campo o se procesan formularios con distribuciones diferentes.
La inteligencia artificial introduce una mayor capacidad de adaptación. Mediante modelos de aprendizaje automático entrenados con diferentes tipos de documentos, el sistema puede reconocer patrones, etiquetas, estructuras y relaciones entre datos sin necesitar que cada elemento aparezca siempre en las mismas coordenadas.
Esto resulta especialmente relevante en organizaciones que trabajan con grandes volúmenes documentales procedentes de múltiples fuentes, ya que permite reducir el número de excepciones que deben resolverse manualmente.
¿En qué se diferencia la extracción de datos con IA de una plantilla documental?
Una plantilla tradicional indica al sistema dónde debe buscar cada dato. Por ejemplo, puede establecer que el número de factura se encuentra en una determinada zona de la primera página.
Un sistema basado en inteligencia artificial intenta identificar qué información representa cada elemento del documento. De esta forma, puede localizar un número de factura aunque aparezca en una posición diferente o esté acompañado por expresiones como “N.º factura”, “Número de documento” o “Referencia de factura”.
¿Por qué la IA puede trabajar con documentos de formatos diferentes?
Porque el análisis no depende exclusivamente de la posición física del texto. Los modelos pueden considerar simultáneamente palabras, etiquetas, proximidad entre elementos, tablas, estructura visual y contexto semántico.
Esta combinación permite interpretar documentos similares aunque hayan sido creados por empresas, departamentos o aplicaciones diferentes.
¿Cuándo resulta especialmente útil utilizar IA en lugar de reglas fijas?
La inteligencia artificial resulta especialmente útil cuando existe una elevada variabilidad documental, se reciben documentos de numerosos proveedores, aparecen nuevos formatos con frecuencia o el coste de mantener manualmente plantillas y reglas empieza a ser elevado.
¿Cómo funciona la extracción inteligente de datos de documentos?
Un proceso de extracción inteligente suele combinar diferentes fases. El objetivo no consiste únicamente en convertir una imagen en texto, sino en comprender qué tipo de documento se está procesando, localizar los datos relevantes y validar que la información obtenida presenta un nivel de confianza suficiente.
¿Cómo clasifica la IA automáticamente un documento?
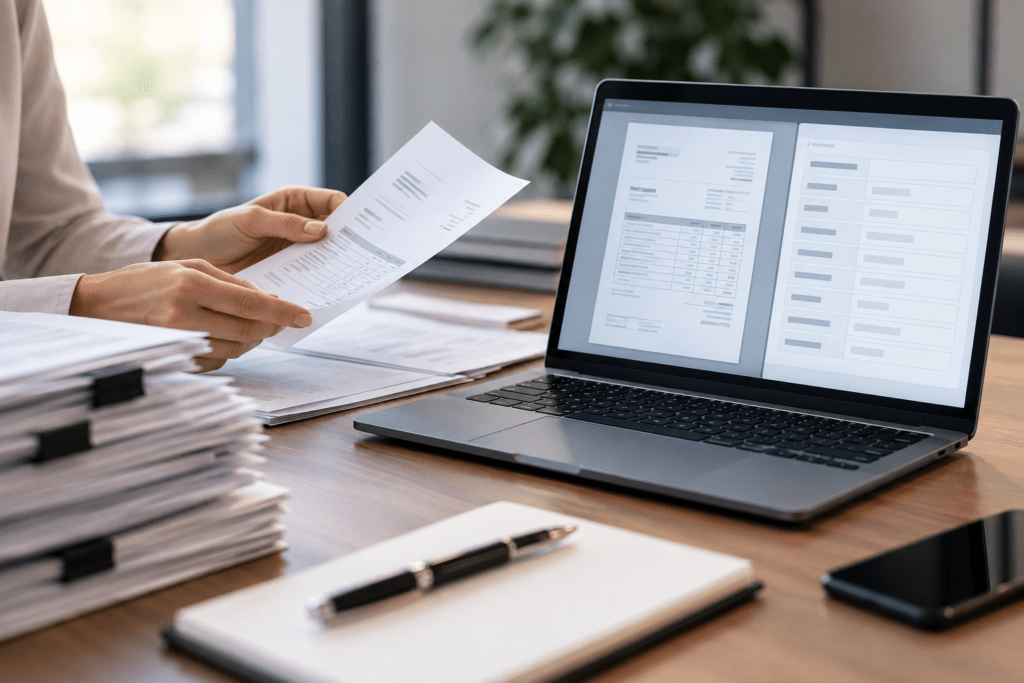
Antes de extraer ningún dato, el sistema puede identificar de qué tipo de documento se trata: factura, contrato, expediente, formulario, albarán, certificado o cualquier otra categoría definida dentro del proceso documental.
Esta clasificación permite aplicar posteriormente los modelos, campos y reglas de validación adecuados para cada tipología.
Por ejemplo, una factura puede requerir la identificación del proveedor, NIF, fecha, base imponible, impuestos e importe total, mientras que un expediente administrativo puede necesitar número de expediente, organismo, interesado, fecha de entrada y tipo de procedimiento.
¿Qué información utiliza la IA para reconocer el tipo de documento?
El sistema puede analizar elementos como títulos, palabras clave, estructura de la página, tablas, logotipos, distribución del contenido o relaciones entre determinados campos.
Esta capacidad permite reducir la dependencia de procesos manuales de clasificación e indexación.
¿Puede clasificarse automáticamente documentación recibida desde distintos canales?
Sí. Cuando el proceso está correctamente integrado, los documentos pueden proceder de correo electrónico, escáneres, repositorios documentales, aplicaciones corporativas u otros canales digitales y pasar posteriormente por un proceso automático de clasificación.
¿Cómo identifica la IA los campos relevantes dentro de un documento?
Una vez determinado el tipo documental, la IA localiza los campos necesarios para el proceso de negocio. Entre ellos pueden encontrarse fechas, importes, NIF, números de factura, referencias de expediente, nombres, direcciones, códigos de producto o identificadores internos.
El sistema analiza tanto el contenido textual como la relación entre los distintos elementos del documento, evitando depender exclusivamente de posiciones preestablecidas.
¿Cómo entiende la inteligencia artificial el contexto de los datos extraídos?
A diferencia de una plantilla rígida, los modelos actuales pueden analizar relaciones entre campos.
Por ejemplo, en una factura pueden aparecer varios valores monetarios correspondientes a líneas de producto, subtotal, impuestos y total. Un sistema inteligente intenta determinar cuál corresponde al importe total interpretando etiquetas, estructura de la tabla y relación con otros conceptos.
¿Cómo distingue la IA entre datos similares dentro del mismo documento?
La identificación se apoya en el contexto semántico y visual. Una fecha situada junto a “fecha de emisión” puede clasificarse de manera diferente a otra situada junto a “fecha de vencimiento”, aunque ambas utilicen exactamente el mismo formato.
¿Qué ocurre cuando un mismo documento contiene varias tablas o bloques de información?
Los modelos pueden analizar los distintos bloques de forma independiente y establecer relaciones entre ellos. Esto resulta útil en documentos complejos que contienen cabeceras, tablas de detalle, totales, observaciones y anexos.
¿Cómo se valida la información extraída automáticamente con inteligencia artificial?
Cada dato extraído puede asociarse a un determinado nivel de confianza. Esta información permite establecer reglas de decisión dentro del proceso.
Los campos con un nivel de fiabilidad elevado pueden continuar automáticamente hacia el sistema de destino, mientras que aquellos que presentan dudas pueden derivarse a una fase de revisión humana.
De esta forma, no es necesario revisar manualmente el 100 % de los documentos, sino concentrar la intervención humana en los casos que realmente presentan incertidumbre.
¿Qué significa el nivel de confianza en la extracción documental?
El nivel de confianza representa la seguridad estimada por el sistema respecto a la correcta identificación de un dato.
Un valor elevado puede indicar que existe una correspondencia clara entre el contenido identificado y el campo esperado, mientras que un nivel reducido puede aparecer ante documentos borrosos, estructuras atípicas, caracteres difíciles de interpretar o información incompleta.
¿Cómo ayuda la validación humana a mejorar la precisión?
La revisión humana permite corregir aquellos campos que presentan dudas y, en determinados sistemas, estas correcciones pueden utilizarse como retroalimentación para mejorar progresivamente los modelos.
¿Es posible automatizar únicamente los documentos con alta confianza?
Sí. De hecho, establecer umbrales de confianza es una estrategia habitual para equilibrar automatización y control. Los documentos o campos que superan determinados criterios pueden procesarse automáticamente y las excepciones pasar a supervisión.
¿Puede un sistema de extracción documental con IA aprender de las correcciones?
Los sistemas basados en aprendizaje automático pueden mejorar su capacidad de reconocimiento cuando disponen de nuevos ejemplos y mecanismos adecuados de retroalimentación.
Cuantos más documentos representativos procesa el sistema, mayor puede ser su capacidad para identificar patrones frecuentes, especialmente cuando las correcciones realizadas durante la revisión humana se incorporan correctamente al proceso de mejora.
¿Qué significa el aprendizaje continuo en un sistema documental?
El aprendizaje continuo consiste en utilizar nuevos casos y correcciones para perfeccionar el comportamiento del sistema a lo largo del tiempo.
Esto resulta especialmente útil cuando aparecen nuevos proveedores, formatos documentales o variaciones que inicialmente no estaban presentes en los datos utilizados para configurar o entrenar la solución.
¿Por qué es importante supervisar el aprendizaje de los modelos?
Porque no todas las correcciones o excepciones deben convertirse automáticamente en nuevas reglas. La supervisión permite garantizar que los cambios introducidos mantienen la calidad del sistema y no generan comportamientos incorrectos en otros documentos.
¿Cuáles son los principales casos de uso de la extracción documental con IA?
La extracción inteligente de datos puede aplicarse a numerosos procesos empresariales y administrativos. Algunos de los usos más habituales son:
- Extracción automática de datos de facturas para su registro contable.
- Clasificación e indexación de expedientes administrativos.
- Captura de campos en formularios con formatos variables.
- Identificación de cláusulas o datos clave en documentación técnica y contractual.
- Digitalización de información procedente de albaranes y pedidos.
- Extracción de referencias, fechas y códigos internos.
- Preparación de datos documentales para integrarlos con ERP, CRM u otras aplicaciones.
- Automatización de procesos que combinan documentos estructurados y no estructurados.
¿Cómo se utiliza la IA para extraer datos de facturas automáticamente?
El sistema puede identificar campos como proveedor, NIF, número de factura, fecha, base imponible, impuestos y total, además de información incluida dentro de tablas o líneas de detalle.
Después de su validación, estos datos pueden utilizarse para reducir las tareas manuales asociadas al registro contable o a otros procesos administrativos.
¿Puede utilizarse la IA para clasificar expedientes administrativos?
Sí. La clasificación inteligente permite analizar la información contenida en cada documento y asociarla automáticamente a un expediente, categoría documental o proceso definido previamente.
¿Puede extraerse información de contratos y documentación técnica?
También es posible analizar contratos y documentos técnicos para localizar referencias, fechas, entidades, apartados concretos u otros elementos relevantes. La complejidad dependerá del tipo de información que se quiera identificar y del grado de variabilidad documental.
¿Qué ventajas tiene automatizar la captura de documentos frente al procesamiento manual?
La principal ventaja es la posibilidad de reducir tareas repetitivas relacionadas con lectura, clasificación, introducción de datos y comprobaciones iniciales.
La automatización no solo afecta a la velocidad de procesamiento. También puede facilitar la estandarización de procesos, mejorar la trazabilidad de la información y permitir que los profesionales concentren su tiempo en las excepciones y decisiones que requieren conocimiento especializado.
¿Cuánto tiempo puede reducir la extracción automática de documentos?
Lo que a un equipo humano puede llevarle horas de lectura e introducción manual de datos puede procesarse de forma mucho más rápida mediante sistemas automatizados, especialmente cuando existe un volumen elevado de documentación.
El ahorro real dependerá del número de documentos, su complejidad, la calidad de las imágenes y el porcentaje de información que pueda procesarse sin revisión.
¿Cómo reduce la automatización los errores de introducción manual?
La fatiga, la repetición y la introducción de grandes cantidades de información pueden generar errores de transcripción. Automatizar determinadas fases reduce esta dependencia de la introducción manual, aunque sigue siendo necesario establecer controles de calidad.
¿Qué tareas pueden realizar los equipos después de automatizar la captura?
El tiempo liberado puede dedicarse a resolver excepciones, validar casos complejos, mejorar los procesos, analizar información o realizar otras actividades donde la intervención profesional aporte más valor.
¿Qué limitaciones tiene la inteligencia artificial para extraer datos de documentos?
La inteligencia artificial no elimina por completo la necesidad de supervisión. La calidad de los resultados puede verse afectada por documentos escaneados incorrectamente, imágenes de baja resolución, textos manuscritos difíciles de interpretar, estructuras excepcionalmente complejas o información incompleta.
Un proyecto bien diseñado combina automatización y puntos de control humano en aquellos momentos donde la revisión realmente aporta valor.
¿Qué documentos son más difíciles de procesar automáticamente?
Los documentos con imágenes borrosas, texto parcialmente oculto, escrituras manuscritas irregulares, estructuras poco frecuentes o escaneos de baja calidad suelen requerir un mayor nivel de revisión.
¿La IA puede procesar documentos manuscritos?
Existen tecnologías capaces de reconocer determinados tipos de escritura manuscrita, pero su precisión depende considerablemente de la legibilidad, la calidad de la captura y las características del documento.
¿Sigue siendo necesaria la intervención humana en la extracción documental?
En muchos proyectos sí, aunque su función cambia. En lugar de introducir manualmente todos los datos, los usuarios pueden concentrarse en verificar excepciones, resolver campos ambiguos y controlar la calidad del proceso.
¿Tienes un gran volumen de documentos por digitalizar?
Planificamos tu proyecto de principio a fin para digitalizar tu archivo con seguridad, trazabilidad y control.
¿Cómo implementar inteligencia artificial para extracción de datos de documentos?
Aplicar inteligencia artificial a la extracción de datos requiere analizar previamente el proceso documental. No basta con incorporar una tecnología de reconocimiento: es necesario definir qué documentos se reciben, qué información debe obtenerse, qué nivel de precisión necesita cada campo y cómo se utilizarán posteriormente los datos.
También resulta recomendable establecer un proceso adecuado de digitalización y determinar qué información es crítica para el negocio.
¿Qué pasos hay que seguir para automatizar la extracción documental?
El primer paso consiste en identificar las tipologías documentales y los campos que deben extraerse. Posteriormente se analiza la variabilidad de los documentos, se establecen los criterios de validación y se determina qué información puede automatizarse completamente y qué casos requieren supervisión.
La siguiente fase consiste en integrar la captura documental con los sistemas donde se utilizará la información.
¿Cómo integrar los datos extraídos con los sistemas de una empresa?
Los datos obtenidos pueden incorporarse a sistemas de gestión documental, aplicaciones internas, ERP, CRM, herramientas contables u otros procesos corporativos, dependiendo de la arquitectura tecnológica de cada organización.
¿Cómo saber qué nivel de automatización necesita cada proceso documental?
No todos los documentos necesitan el mismo grado de automatización. La decisión debe considerar el volumen, la variabilidad, la relevancia de los campos, la calidad de los originales y las consecuencias que tendría procesar un dato incorrectamente.
En Dinser integramos tecnologías de IA en nuestros procesos de captura y clasificación documental, adaptando el nivel de automatización a la complejidad real de cada tipo de documento y a las necesidades específicas de cada proceso.
Preguntas frecuentes sobre inteligencia artificial y extracción de datos de documentos
¿Qué es la inteligencia artificial para extracción de datos de documentos?
La inteligencia artificial para extracción de datos de documentos es el uso de tecnologías capaces de identificar, interpretar y convertir automáticamente la información contenida en facturas, formularios, contratos, expedientes u otros documentos en datos estructurados. A diferencia de los sistemas basados exclusivamente en plantillas, puede adaptarse a cambios en el formato y analizar el contexto del contenido.
¿Qué tipos de documentos puede procesar un sistema de extracción de datos con IA?
Puede utilizarse con facturas, albaranes, formularios, expedientes administrativos, contratos, certificados, documentación técnica y otros documentos estructurados o semiestructurados. La capacidad de automatización dependerá de la calidad del documento, la variabilidad de sus formatos y los datos que sea necesario identificar.
¿Cuál es la diferencia entre OCR e inteligencia artificial para extracción documental?
El OCR se utiliza principalmente para reconocer caracteres y convertir una imagen o documento escaneado en texto digital. La inteligencia artificial puede añadir una capa posterior de interpretación para determinar qué representa cada elemento, clasificar el documento, reconocer campos concretos y establecer relaciones entre los datos identificados.
¿La inteligencia artificial puede extraer datos de facturas con formatos diferentes?
Sí. Una de las principales ventajas de utilizar modelos inteligentes es que pueden identificar campos como número de factura, proveedor, fecha, impuestos o importe total aunque su posición cambie entre documentos. El rendimiento dependerá del modelo utilizado, la calidad de los documentos y la variabilidad existente.
¿Cómo elegir una solución de inteligencia artificial para automatizar documentos?
Conviene analizar el volumen de documentos, los formatos existentes, los campos que deben extraerse, la precisión necesaria, las posibilidades de validación humana y la integración con los sistemas actuales de la organización. La mejor solución no es necesariamente la que automatiza todos los casos, sino la que consigue un equilibrio adecuado entre precisión, velocidad, supervisión y coste operativo.